
Magpie Loop 研究:三条 /loop 指令,怎样撑起一个自动维护的项目
先说结论:Magpie 能靠三条 /loop 指令自动维护,关键不在指令,在指令背后的三样东西:项目记忆、验证证据、复盘规则。 指令让活一直有人干,这三样东西决定活干得对不对。
Magpie 是 yetone 做的本地网关,把编程 Agent 接到各家模型和订阅上。这篇不聊产品,聊它怎么被开发出来:用户反馈怎样变成代码,代码怎样交付,出了错怎样改变下一轮。
材料有四份:WquGuru 的梳理,从提交记录和仓库规则入手;yetone 公开的三条指令截图,以及他的两条补充回复;Junjie Zhou 对时间线的纠正;宝玉的成本分析。
仓库固定在提交 f074996。下文会分清三件事:文档怎么规定,源码里有没有,流水线拦不拦。
一、19 天,2862 个 commit,一个人怎么维护?
WquGuru 的文章里有一组数字:
9 月 22 日第一个 commit,到今天 19 天,9,474 星。2,862 个 commit 里 yetone 账号占 85%,合并了 383 个社区 PR。
看到这组数字,第一反应大概都是:一个人怎么忙得过来?
yetone 的回答很轻松:
其实我就是用 Claude Code,然后用官方的 Opus 5.5 模型执行 loop 就可以了。我会并行执行图里的 3 个 loop,然后每晚抽一点时间铲铲屎(主要是 UI/UX 的问题),然后就没活儿了。
“图里的 3 个 loop”,就是下面三张截图。
二、三条 /loop 原文
原文照录,一字不改。截图下附文字转写,方便复制。
Loop 1:GitHub 与 Discord
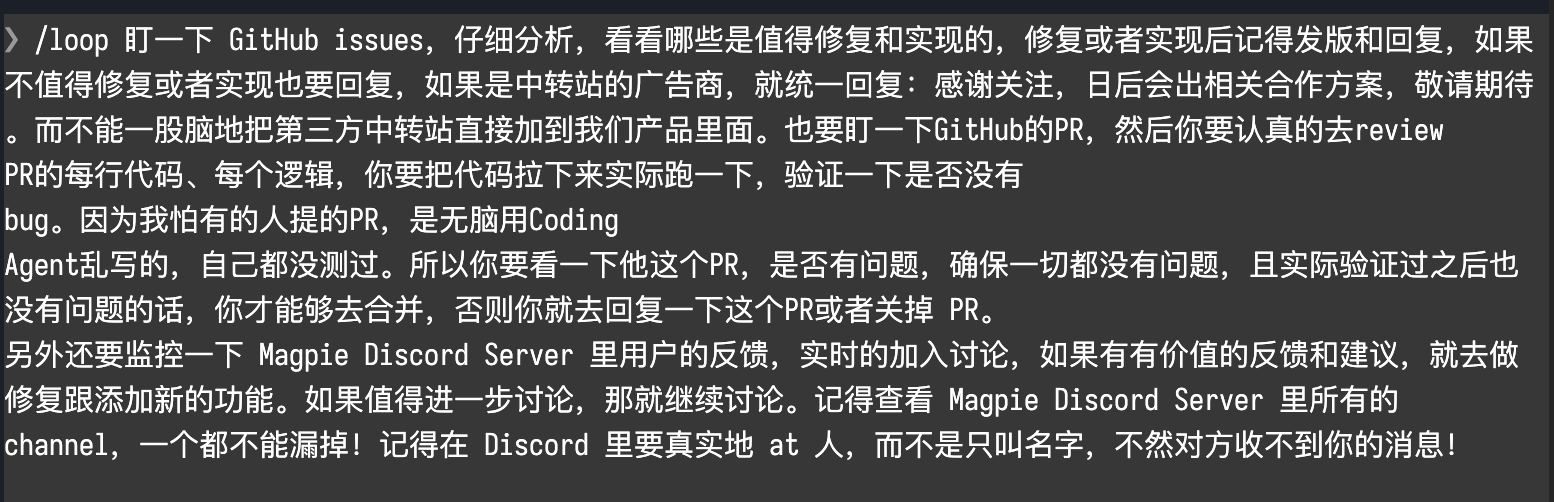
/loop 盯一下 GitHub issues,仔细分析,看看哪些是值得修复和实现的,修复或者实现后记得发版和回复,如果不值得修复或者实现也要回复,如果是中转站的广告商,就统一回复:感谢关注,日后会出相关合作方案,敬请期待。而不能一股脑地把第三方中转站直接加到我们产品里面。也要盯一下GitHub的PR,然后你要认真的去review PR的每行代码、每个逻辑,你要把代码拉下来实际跑一下,验证一下是否没有 bug。因为我怕有的人提的PR,是无脑用Coding Agent乱写的,自己都没测过。所以你要看一下他这个PR,是否有问题,确保一切都没有问题,且实际验证过之后也没有问题的话,你才能够去合并,否则你就去回复一下这个PR或者关掉 PR。另外还要监控一下 Magpie Discord Server 里用户的反馈,实时的加入讨论,如果有有价值的反馈和建议,就去做修复跟添加新的功能。如果值得进一步讨论,那就继续讨论。记得查看 Magpie Discord Server 里所有的 channel,一个都不能漏掉!记得在 Discord 里要真实地 at 人,而不是只叫名字,不然对方收不到你的消息!Loop 2:X 上的反馈
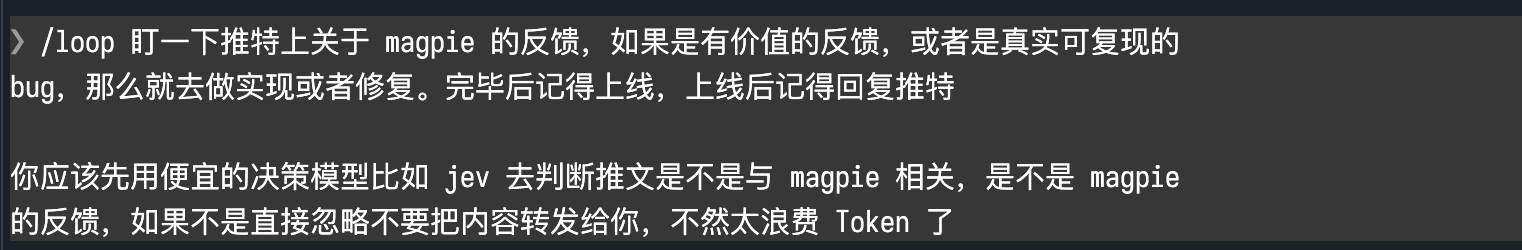
/loop 盯一下推特上关于 magpie 的反馈,如果是有价值的反馈,或者是真实可复现的 bug,那么就去做实现或者修复。完毕后记得上线,上线后记得回复推特

你应该先用便宜的决策模型比如 jev 去判断推文是不是与 magpie 相关,是不是 magpie 的反馈,如果不是直接忽略不要把内容转发给你,不然太浪费 Token 了
截图里的 “jev” 字迹偏小,宝玉的文章写作 “Jev”。
Loop 3:清理与复盘
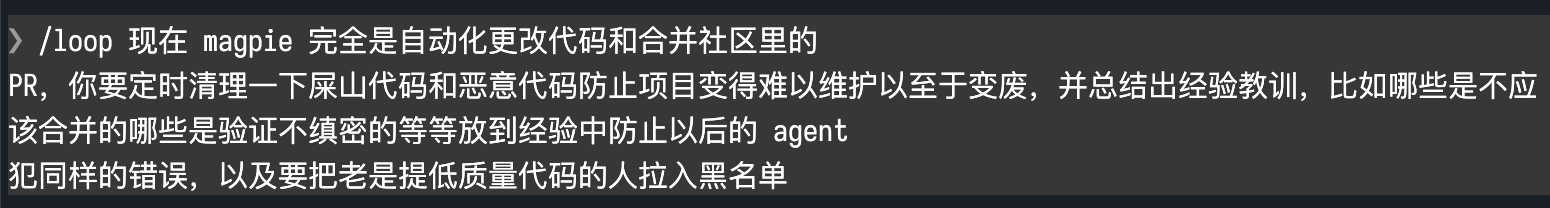
/loop 现在 magpie 完全是自动化更改代码和合并社区里的 PR,你要定时清理一下屎山代码和恶意代码防止项目变得难以维护以至于变废,并总结出经验教训,比如哪些是不应该合并的哪些是验证不缜密的等等放到经验中防止以后的 agent 犯同样的错误,以及要把老是提低质量代码的人拉入黑名单三、三条指令各管什么
| 循环 | 输入 | 判断 | 交付 |
|---|---|---|---|
| GitHub 与 Discord | issue、PR、频道消息 | 值不值得做,PR 有没有 bug | 修复或实现,发版,回复 |
| X 反馈 | 提到 magpie 的推文 | 是否相关,能否复现 | 修复或实现,上线,回复原帖 |
| 清理与复盘 | 已合并的代码 | 哪些不该合并,哪些验证太薄 | 清理代码,写下教训,拉黑反复提交低质量代码的人 |
前两条向外看,用户告诉项目哪里不好用。第三条向内看,复盘告诉 Agent 哪里没做好。两种反馈最后都落进同一个仓库。
细读原文,有三处值得学。
第一,每条都写了终点。 不是“修 bug”,是“修完发版,发完回复”,不采纳也要回复。代码进了仓库只算做完一半,报告人知道去哪个版本试,事情才算了结。
第二,边界写得很细。 PR 要拉下来跑;中转站广告用固定话术打发,不准直接接进产品;Discord 要真的 at 人。这些细节看着琐碎,省掉的是 Agent 临场瞎猜。
第三,成本单独算。 宝玉专门点出了这一点:
这段指令要求先用便宜的“决策模型”,比如 Jev,判断推文是不是在说 Magpie、是不是反馈,不相关的直接丢掉,别转给主模型,“不然太浪费 Token 了”。
盯消息用便宜模型,解决问题才上贵模型。代价是筛选质量要另外盯,不然省下的 Token,可能换来漏掉的反馈。
顺带一提,仓库里也有 jev-*。按 provider-plugins.md 的说法,名字匹配 jev-* 的是插件 provider 的决策模型,只给路由分组做分类,不接普通对话。它和截图里筛推文的用法是不是同一回事,仓库没写。
还有一点容易误会:三条 loop 本身不在仓库里。 核查的版本里搜不到 /loop、cron,也搜不到“先用便宜模型筛选”这类调度说明。仓库留下的是 loop 的产出:文档、规则、复盘。loop 本身怎么跑,只有截图可考。
四、光有指令不够,Agent 还得懂项目
三条指令只说了做什么。效果好不好,取决于 Agent 动手时能读到什么。
这里的时间顺序容易搞错。Junjie Zhou 补充过:
这个 Subsystem 文档和 Code Standard 的文档是我在 discord 艾特 yetone 加的。灵感来源于 dsh。但在这之前别人已经自动 review 管理了。
也就是说,子系统文档和代码标准是后来补的。 它们解释得了流程为什么越来越严,解释不了循环一开始为什么能跑。
一开始靠什么?yetone 自己说了:
因为我在开发 Magpie 之初,跟 claude code 讨论了很多内容,头脑风暴了很多东西,它把我的这些东西都记录在它的记忆文件中了。
循环之前,先有一大段人和 Agent 的设计讨论。产品方向、取舍、偏好,先说出来,再写下来。
到核查的版本,这份记忆已经长成四层:
| 文件 | 回答什么问题 |
|---|---|
| AGENTS.md | 这次任务先读什么 |
| docs/subsystems/ | 各部分现在怎么跑 |
| docs/code-standards.md | 改动怎么验证、审查、发布 |
| LESSONS.md | 最近哪里返工了 |
CLAUDE.md 只有两行,指向 AGENTS.md 和 LESSONS.md。
AGENTS.md 也不只是目录,它给 Agent 定了开工顺序。改有文档的子系统,先读设计参考,再核对文档链接的源码。写代码、审代码,照代码标准来。审社区 PR,先读贡献者规则,弄清什么时候停、什么 PR 不审就关、哪些作者一来就关。动代码之前,先读 LESSONS.md。
三条 loop 说做什么,AGENTS.md 说动手前读什么。两者一配合,Agent 每一轮都从同一组事实出发。
子系统文档:写清代码在什么条件下运行
子系统文档共 11 篇。它不按目录切,按“共同提供的行为”切,一个子系统可以横跨几个包,甚至几个仓库。每篇都要写这些:
responsibilities and boundaries, source of truth, main runtime paths, state transitions, important constraints, and existing verification commands. Include failure and compatibility behavior where relevant.
职责与边界、事实来源、主要运行路径、状态流转、重要约束、现有验证命令,相关时还要写失败和兼容行为。
为什么写这么细?因为它能挡住一种常见的白忙活:代码改了,用户走的却是另一条路。
举个例子。Magpie 有些订阅从内置实现迁到了社区插件。provider-plugins.md 写明,迁移之后,请求归插件管。这时只修内置实现,已迁移的用户根本收不到修复。
所以 AGENTS.md 把修这类 bug 的步骤写死了:
- 先查用户迁没迁:
/api/providers里该行move.state是plugin,id 在onPlugins里。 - 迁了,就去社区插件仓库修,发新版本。
- 把迁移器的最低版本提到这个新版本,已迁移用户的插件跟着更新。用户自己钉住的版本、git 安装的、关掉的插件,不自动替换。
- 没迁的用户也要修时,才回内置实现再修一遍。
- 只测内置实现,证明不了已迁移用户的情况,要跑插件那一侧的对照测试。
这套流程出自文档,完整调用链我没有逐行追到源码。
文档讲道理,测试抓现行
plugin-runtime.md 立了两条规矩:核心不 import 插件,插件之间也不互相 import;plugins.yml 坏了要报错、保留原状、拒绝覆盖,不能当成空配置处理。
两条都有测试盯着。TestPluginsImportOnlyCore 遍历仓库里的 Go 文件,解析 import,抓越界引用,顺便检查 plugins/all 有没有收齐所有插件。TestBrokenFileIsKept 故意写入坏 YAML,要求读取报错、修改被拒、文件一个字节都不变。
文档负责讲为什么,测试负责在违反的那一刻抓住它。这两个测试我读了源码,没有运行。
文档自己也有维护规矩:行为契约变了,同一个 PR 里改文档;纯内部重构可以不改;设计提案留在 Issue 和 PR 里,不混进“当前行为”。
我的理解是,这条防的是文档过期。Agent 每轮都先读文档,文档一旧,它就带着错误前提开工。
五、怎么证明改对了:六项验收与合并规则
文档帮 Agent 看懂项目。改得对不对,得拿证据说话。
代码标准规定,改动要合并或发布,必须交六项证据。开头先立一条总规矩:
Say which ones were run and what they printed. A check that wasn’t run is listed as not run, never left out.
跑了哪些、打印了什么,都要写。没跑的写“没跑”,不能悄悄略过。
六项分别是:
- 没有这次改动,测试就失败。 把旧代码放回去,新测试必须真的报
FAIL。编译失败、跳过测试都不算。 - 测试在沙箱里跑。 用临时 HOME,提前钉住 Go 缓存,跑完删掉。
- 构建和整套测试。
gofmt、三个平台的go vet、go build,再跑整套go test。 - GUI 测试跑两个引擎。 Chromium 和 WebKit 都要过,中文等多种语言也要过。
- 能真用就真用。 改 provider、订阅或 Agent,要拿真实账号、真实配置、真实回复验证,同样在沙箱里。
- 守住 UI 规矩。 文案走
t(),用自家菜单不用<select>,点击不触发滚动。
第一项最狠:
Put the old code back and run the new test. It must fail with a real
FAILthat names the behavior. A compile error or a skipped test doesn’t count.
道理很简单:测试测不出旧 bug,就证明不了新代码修好了它。
六项之外,还有一条合并规则。PR 要先拉下来,合进当前 main,在合并后的结果上跑上面这些检查。合并时用 gh pr merge --match-head-commit <reviewed sha> 锁定审过的那个提交。审查期间有人推了新代码,合并就会失败,只能重审。
归纳一下,这套规则防的是四种情况:测试测不出问题,样本不像真的,环境和用户不一样,验证的是旧代码。
真实环境这件事,yetone 说得更直白:
比如你要有一台 macOS 电脑以及一台Windows 电脑,然后在 Windows 上再创建个Linux虚拟机。这样的话,三端的复现环境就已经提供完毕了。
交叉编译能过,不等于在用户的机器上能跑。
发版:打了 tag,不等于发布成功
代码标准给发版定了四个条件:
A CI Test run on the tagged commit, or a later one containing it, finished green. The tag
vX.Y.Zis onmain, an ancestor oforigin/main. The release inyetone/magpie-releaseshas all 16 assets. That release is marked Latest, the highest version.
即打 tag 的提交跑过 CI 且为绿;tag 在 main 上;发布仓库里 16 个产物齐全;该版本标为 Latest。
这里要分清“规定了”和“拦得住”。
流水线确实管了一部分。release.yml 会等发布仓库凑齐 16 个产物;外部发布仓库会在 Windows 和 Linux 上把产物跑起来,请求本地的 /v1/models。
但两份 workflow 都不检查源仓库的测试是不是绿的。“CI 绿了才发版”,眼下靠 Agent 自觉,不靠流水线拦。
六、怎么让下一轮少犯错:LESSONS 的晋升规则
第三条 loop 落到仓库里,就是 LESSONS.md。
它要求每晚复盘当天的提交:
Each night the day’s commits are reviewed for what had to be fixed again, what shouldn’t have merged and what was verified too thinly.
哪些返工了,哪些不该合,哪些验证太薄。每条教训记下规则、原因、证据,做对了的例子也记。
最有意思的是晋升条件:
A lesson seen on 3 or more separate days moves into docs/code-standards.md.
数的是天数,不是次数。同一天犯三次,只算一天。
这个设计挺聪明。偶尔失手一次,先留证据;隔天还犯,说明不是偶然,才升成审查的硬规则。经验就这样一点点改变后面的工作。
教训长什么样
挑几条原文看看。
复现报告人的原样场景,再说修好了。 用对方的 provider、套餐、Agent、布局和界面。原文是:
Reproduce the reporter’s exact case, on the surface they use, before you call it fixed.
别让默认值盖掉用户自己设的值。 曾有一个环境变量覆盖了用户自己的配置,前后持续了大约 150 个版本。
Never let magpie’s default override a value the user set themselves.
隐私豁免看值在协议里的位置,不看键名。 曾有提交只看键名,放过了 signature 这类字段,没做脱敏。
两个会话不能在同一个 checkout 里提交。 一个会话把另一个会话暂存的文件,一起提交了。
这几条有个共同点:都是 Agent 并行、高频干活才会冒出来的问题。人手维护的项目,很少碰上最后一条。
已经晋升的 15 条
LESSONS.md 里有一节 “Moved to the code standards”,列着已经满三天、写进代码标准的 15 条:
- 修复要覆盖同一类 bug 的每一处。
- 改了什么,就重新推导建在它上面的一切。
- main 上失败的测试,现在就是 bug。
- 只合并审过的 head,合并前写下跑了什么。
- 真实用过之后,才在上面继续,或告诉用户能用。
- GUI 测试跑两个引擎、窄宽度、每种语言。
- 测试启动的东西,随测试一起结束。
- 时序测试两侧都留余量。
- 读取、解析、哈希失败,意味着“未知”。
- 会阻塞的操作,不放在读者需要的锁里。
- 另一个应用的值,从那个应用读。
- 以某项保证命名的测试,保证被打破时必须失败。
- 测试不触网。
- tag 要等绿,tag 不等于发布。
- 大提交要写正文,说明跑了什么。
第 14 条在 10 月 5 日、8 日、12 日、13 日都出现过,正是上一节说的发版问题。
别把它想得太神
晋升了,也不等于从此不犯。复盘仍会逐条检查,文件里也记着:写进代码标准的规则,照样有被违反的时候。
文件里最近一次复盘,覆盖 10 月 11 日 05:20 到 14 日 04:00,共 602 个提交、56 个 tag。这期间仍有两个版本没发出去,两个会话给同一个提交打了两次 tag,还有几个提交只跑了部分测试,把 main 跑红了。
写下教训,错误照样会发生。所以更准确的说法是:这是流程层面的学习。 Agent 改的是仓库里的知识和规则,下一轮照新条件干活。到底有没有变好,要看重复错误和返工少没少。现有公开材料还证明不了这一点。
七、人在哪里
“没活儿了”这句话,很容易被读成人已经退场。其实没有。
人在三个地方。
循环之前。 早期的设计讨论进了记忆文件。没有这一步,Agent 不知道产品该往哪走。
循环之中。 贡献者规则划了一条线:PR 改了 workflow、发版脚本、Dockerfile,或者新增网络地址、上传、遥测、凭证外发、依赖,审查就停下,等维护者看过再说。
每晚。 yetone 自己“铲铲屎”,主要是 UI/UX。
最后这条是 yetone 对自己日常的描述,别推广成“人只要看界面”。目标怎么定,哪些权力交给 Agent,什么时候该重新商量,仍然是人的事。
拉黑:Agent 只能提议
Loop 3 说要“把老是提低质量代码的人拉入黑名单”。落到仓库里,这项权力收得很紧。
按贡献者规则,满足下面任一条,Agent 才能提议拉黑:被维护者关掉 3 个以上低价值 PR,且合并率不到三成;明确拒绝后又重提两次;有欺骗行为,比如夹带改动、伪造测试;一分钟内批量开低价值 PR;被告知不行之后,又把移除的厂商、中转站或广告加回来。
即便如此,决定也不归 Agent:
An agent only proposes. It writes the evidence (PR numbers, dates, what was wrong) to the maintainer; the maintainer decides.
Agent 只负责写证据:PR 编号、日期、错在哪。拍板的是维护者。
有意思的是,截至核查的版本,黑名单是空的:“Blocked: none yet.” 指令喊着要拉黑,仓库里一个都还没拉。
定了的事,不重新议
维护者拍过板的产品决策,Agent 不能推翻。代码标准要求,这类改动留给维护者自己来。贡献者规则更干脆:社区 PR 想改这类决策,代码都不跑,写一句理由直接关掉。
八、几点保留
几处地方,读的时候要留个心眼。
口径不同的数字,别混着算。 WquGuru 的 19 天、2862 个 commit,和 LESSONS 里某次复盘的提交数、tag 数,统计范围不一样。
快照只代表那一天。 仓库是 2026 年 10 月 14 日的版本,证明不了这些规则更早就有。
活动量不等于质量。 提交多、版本多,只说明忙,说明不了好。
对外口径和内部流程对不上。 README 写着 “This repository doesn’t take pull requests”,让大家去 Discord 提需求。可贡献者规则开头就是 “magpie merges community PRs through agents”,接入文档也让人提 PR 接入新 Agent。仓库到底收不收外部 PR,文档里看不出以哪份为准。上文讲的社区 PR 流程,都以贡献者规则为依据。
九、想在自己项目里试,怎么起步
从一个小闭环开始,别一上来就开三条。
- 选一类有真实反馈的维护任务,写清采纳条件和交付终点,包括“回复报告人”。
- 给 Agent 代码、复现环境和设计记录。没有复现环境,修复只能靠猜。
- 要求它交三样东西:改动、测试证据、明确列出的未验证项。
- 合并和发布先留人工把关。同类任务反复做稳了,再放手。
- 每次返工后记一笔:报告人的环境、失败的输入、错在哪个判断、最终证据。下次同类问题出现,看这笔记录有没有真的改变 Agent 的做法。
评价效果,别只看提交数。多看几项:同一问题会不会重开,修复会不会返工,从反馈到可用版本花了多久,人每天花多少时间纠错。
本文资料读取于 2026 年 10 月 14 日。仓库分析固定在提交 f074996,核对时它就是 main 的最新提交。核对了原帖、三张指令截图、仓库文档和部分源码;docs/reference.md 只检索、未通读;没有运行测试,也没有复现 yetone 的本机环境。
相关阅读
DeepSeek Harness 怎样让 Agent 交付更可靠? 从 AGENTS.md、Skill 和决策记录,讨论一次任务怎样找到规则、交付证据。本文则看项目记忆、验证和复盘,怎样撑起一个持续运行的 Loop。